日経平均オプション理論価格等情報のPandas読み込み~整形まで

金融工学のお勉強に公開データを使ってブラックショールズ方程式のお勉強。お勉強開始にあたってデータ準備まで。使っている技術の詳細は以下の本で。


リファレンス環境

  • Windows 10
  • Python 3.6.0
  • Anaconda 4.3 - 5.0.1
  • Pandas 0.19.2

Jupyter起動~ライブラリ読み込み

%matplotlib inline
# %matplotlib notebook
import pandas as pd
import requests, zipfile, io, dateutil
from datetime import datetime

便利関数定義

あとでcsv読み込み時に使う便利関数

def strip(text):
    try:
        return text.strip()
    except AttributeError:
        return text

データ準備

オプション理論価格等情報 | 日本取引所グループから入手した2017年2月10日の終値データ。 色々入っているけど2017年3月限の原資産:日経225のオプション取引データだけ使う。

ファイル取得~展開

2018年1月12日のデータを取得して、csvを展開します。

# 取得する日付
DL_Date = "20180112"
# 対象とする限月
MatMon = "201802"

# オプション理論価格等情報
#    利用ガイド:http://www.jpx.co.jp/markets/derivatives/option-price/01.html
#    一覧: http://www.jpx.co.jp/markets/derivatives/option-price/index.html
url = "http://www.jpx.co.jp/markets/derivatives/option-price/data/%s.zip"
file = "ose%stp"%DL_Date

r = requests.get(url%file)
z = zipfile.ZipFile(io.BytesIO(r.content))
z.extractall()

Pandasへデータ読み込み

  1. データ本体と別に配布されているヘッダー情報をもとに自分でヘッダーを起こして名前をつける
  2. 読み込み中にテキストデータの空白をトリムする
# ヘッダー名 (変数名順)
#     商品コード, 商品タイプ, 限月, 権利行使価格, 予備
#     プットオプション: 銘柄コード, 終値, 予備, 理論価格, ボラティリティ
#     コールオプション: 銘柄コード, 終値, 予備, 理論価格, ボラティリティ
#     原資産終値, 基準ボラティリティ
colName = ("CODE","TYPE","MATURITY","STRIKE", "RSV", 
          "PUT_CODE", "PUT_PRICE", "PUT_RSV", "PUT_TPRICE", "PUT_VOLATILITY",
          "CALL_CODE","CALL_PRICE","CALL_RSV","CALL_TPRICE","CALL_VOLATILITY",
          "F225_PRICE", "Base_VOL")

df_raw = pd.read_csv(file+".csv", names=colName,
                converters = {'CODE' : strip,
                              'TYPE' : strip})
df_raw.head()

読み込んだデータの確認。

CODE TYPE MATURITY STRIKE RSV PUT_CODE PUT_PRICE PUT_RSV PUT_TPRICE PUT_VOLATILITY CALL_CODE CALL_PRICE CALL_RSV CALL_TPRICE CALL_VOLATILITY F225_PRICE Base_VOL
0 NK225E OOP 201703 11000.0 182031018 0.0 0.0 0.94 0.674892 192031018 8350.0 0.0 8372.22 0.792450 19378.93 0.1717
1 NK225E OOP 201703 11250.0 182031218 0.0 0.0 0.99 0.652465 192031218 0.0 0.0 8122.22 0.763183 19378.93 0.1717
2 NK225E OOP 201703 11500.0 182031518 0.0 0.0 1.03 0.627990 192031518 7850.0 0.0 7872.21 0.734523 19378.93 0.1717
3 NK225E OOP 201703 11750.0 182031718 1.0 0.0 1.07 0.603704 192031718 0.0 0.0 7622.20 0.706439 19378.93 0.1717
4 NK225E OOP 201703 12000.0 182032018 0.0 0.0 1.10 0.579896 192032018 0.0 0.0 7372.20 0.678904 19378.93 0.1717


データ整形

2017年3月限の日経225オプションだけ抜き出し。ついでに要らない列を削除してスッキリ。

df_raw = df_raw.query("MATURITY == %s & CODE==\"NK225E\""%MatMon)\
    .drop(['RSV','PUT_RSV','CALL_RSV','PUT_CODE','CALL_CODE','CODE','TYPE','MATURITY'], 1)
  • PUTとCALLが分かれてしまっているので、データを正規化。
  • CALL列がTRUEのときCALLのデータ、FLASEのとき、PUTのデータとする。
  • 行使価格も14000円以上、22000円未満に絞る
df_p = df_raw[["STRIKE","PUT_PRICE","PUT_TPRICE", "PUT_VOLATILITY","F225_PRICE", "Base_VOL"]]\
    .rename(columns={'PUT_PRICE': 'OP_PRICE', 'PUT_TPRICE':'OP_TPRICE', 'PUT_VOLATILITY':'OP_VOL'})
df_p['CALL'] = False
df_c = df_raw[["STRIKE","CALL_PRICE","CALL_TPRICE", "CALL_VOLATILITY","F225_PRICE", "Base_VOL"]]\
    .rename(columns={'CALL_PRICE': 'OP_PRICE', 'CALL_TPRICE':'OP_TPRICE', 'CALL_VOLATILITY':'OP_VOL'})
df_c['CALL'] = True
df = df_p.append(df_c).query("OP_PRICE > 1.0 & STRIKE < 25000 & STRIKE >= 22000")
del (df_p,df_c)
df.head()

CALLとPUTで共通の列名に変更。

STRIKE OP_PRICE OP_TPRICE OP_VOL F225_PRICE Base_VOL CALL
17 15250.0 2.0 1.53 0.318070 19378.93 0.1717 False
18 15500.0 2.0 2.00 0.306616 19378.93 0.1717 False
19 15750.0 3.0 2.56 0.294521 19378.93 0.1717 False
20 16000.0 3.0 3.00 0.279297 19378.93 0.1717 False
21 16250.0 5.0 5.00 0.275828 19378.93 0.1717 False

データの可視化

オプション価格情報をPUT, CALL別にプロット

cmap = plt.get_cmap('rainbow')
fig, ax = plt.subplots()

for i, (key, group) in enumerate(df.groupby(['CALL']), start=1):
    ax = group.plot(ax=ax, kind='Scatter', x='STRIKE', y='OP_PRICE',color=cmap(i / 2.0),label = "CALL" if key else "PUT")
    
plt.title(u"MAT %s / %s close"%(MatMon, DL_Date))
fig.patch.set_facecolor('white') 
plt.show()

理論価格とか基準ボラティリティって何だろうね。

Python環境でVisual StudioのCコンパイラのエラーに困ったら…

Windows環境でPythonを頑張る皆さんお元気ですか?MinGWのGCCを使わずに努力されている勇者もいるかもしれません。そんな同志のための対策メモ書きです。

想定される場面

  • Visual Studio Build Tool環境で“rc.exe が見つかりません”というエラーが出る
  • CythonでVCコンパイラがエラーをはく
  • SwigでVCコンパイラが文句を言う
  • Jupyterノートブックで%%Cythonマジックが上手く機能しない
  • Chainerなどのインストール時にVisual Studioがイヤイヤ期
  • VCコンパイラがcrtなんやらdllが見つからないとか反抗期

リファレンス環境

  • Windows > 7
  • Python > 3.6.0
  • Anaconda > 5.0
  • Visual Studio 2019 Build Tools
  • Visual Studio 2017 Build Tools
  • Visual Studio 2015 Build Tools(2017と両方入っています)


vswhereのインストール

Visual Studio 2017以降のインストールパスを探し当てるのが中々面倒なので、コマンドラインツールvswhereを使うmicrosoft/vswhereにはVisual Studio 2017以降標準でついてくるとか書いてあるけど、パスの設定や管理が面倒なので、 scoopを使ってインストールします。公式はchocolateyを使おうとか書いてある。

chocolateyではなく、scoopにした理由はWindows開発環境の構築をChocolateyからscoopに切り替えるに詳しい。

scoopの準備

パッケージ管理が楽になるので Scoopを使います。やさしいインストール手順はWindowsコマンドラインツールScoopのすすめ(基礎編) - Qiitaを参照していただいて、vswhereはextrasのbucketに入っているので、これを追加してからインストール。

scoop bucket add extras
scoop install vswhere

対策

vswhereを使う場合

vswhereなどでvcvarsallのパスを特定し、これを呼び出すバッチを実行する

@setlocal EnableDelayedExpansion
@setlocal ENABLEEXTENSIONS
@echo off

REM 使いたいVisual Studioのバージョンを指定
REM Visual Studio 2017ならば15
REM Visual Studio 2015ならば14
REM Visual Studio 2013ならば12
REM Visual Studio 2011以下は別途改造必要
set MSVC_VERSION=15

REM 環境設定とvcvarsall.batのパス取得
if %MSVC_VERSION% GEQ 15 (
    for /f "usebackq tokens=*" %%i in (`vswhere -latest -products * -property installationPath`) do (
      set batch_file=%%i\VC\Auxiliary\Build\vcvarsall.bat
    )
) else (
    set batch_file=!VS%MSVC_VERSION%0COMNTOOLS!..\..\VC\vcvarsall.bat
)
REM vcvarsall.bat実行
@echo on
call "%batch_file%" %processor_architecture%
REM 以下に実行したいコマンドを追加
REM Swigやjupyter notebook, cythonなど…

vswhereを使わない方法

cmd/poweshell

vswhereを利用できない場合、レジストリに登録されているパスを使う。vswhereを使っている行を書き換えてください。

REM Visual Studio 2017のインストール取得用のキー
set KEY_NAME="HKEY_LOCAL_MACHINE\SOFTWARE\WOW6432Node\Microsoft\VisualStudio\SxS\VS7"
set VALUE_NAME=15.0

REM 環境設定とvcvarsall.batのパス取得
if "%MSVC_VERSION%"=="15" (
    for /F "usebackq tokens=1,2,*" %%A in (`REG QUERY %KEY_NAME% /v %VALUE_NAME%`) do (
        set batch_file=%%CVC\Auxiliary\Build\vcvarsall.bat
    )
)

Jupyter Notebookの場合

さきのコマンドを実行してからJupter notebook!

これで、cythonマジックは機能するようになりますが、distutilsが基本的にVS2015までしか対応していないようなので、 VS2017の設定でvcvarsall.batを実行しても、VS2015でビルドがされます。 リンカなどは2017のライブラリなどを参照している可能性がありますが、不思議なことにエラーが出ません。

このバッチをmyjup.cmdなどの名前でshift-JISで作業フォルダ以下に保存して使っています。

@setlocal EnableDelayedExpansion
@setlocal ENABLEEXTENSIONS
@echo off

REM 使いたいVisual Studioのバージョンを指定
REM Visual Studio 2017ならば15
REM Visual Studio 2015ならば14
REM Visual Studio 2013ならば12
REM Visual Studio 2011以下は別途改造必要
set MSVC_VERSION=15

REM Visual Studio 2017のインストール取得用のキー
set KEY_NAME="HKEY_LOCAL_MACHINE\SOFTWARE\WOW6432Node\Microsoft\VisualStudio\SxS\VS7"
set VALUE_NAME=15.0

REM 環境設定とvcvarsall.batのパス取得
if "%MSVC_VERSION%"=="15" (
    for /F "usebackq tokens=1,2,*" %%A in (`REG QUERY %KEY_NAME% /v %VALUE_NAME%`) do (
        set batch_file=%%CVC\Auxiliary\Build\vcvarsall.bat
    )
) else (
    set batch_file=!VS%MSVC_VERSION%0COMNTOOLS!..\..\VC\vcvarsall.bat
)
REM vcvarsall.bat実行
@echo on
call "%batch_file%" %processor_architecture%
jupyter notebook


参考

MCMCと単回帰

問題のおさらい

アヒル本の第4章のデータRStanBook/data-salary.txt を教材に、MCMCのアルゴリズムの勉強を進めています。ことの発端と調査着手の経緯は過去ページをご覧になっていただくとして、ランダムウォーク・メトロポリス・ヘイスティングス法(Random Walk MH法)とハミルトニアン・モンテカルロ法(HMC法)に自分で組みながら単回帰に取り組みましたので その内容をまとめます。

StanとRでベイズ統計モデリング (Wonderful R)
  • 作者: 松浦健太郎, 石田基広
  • 出版社/メーカー: 共立出版
  • 発売日: 2016/10/25


単回帰問題の内容

架空データはB社の社員の年齢X(歳)と年収Y(万円)のデータで、20人分のサンプルがある。このサンプル数20という絶妙なサンプル数の単回帰を行い、予測に使おうという問題です。このうちの予測ではなく、単回帰までのところで、色々やっています。

データ: RStanBook/data-salary.txt

このデータは、$ Y_i \sim \mathcal{N}(a + b \cdot X_i, \sigma^2) $ で表現されるモデルにおいて、最尤法では $ \hat{a} = -119.697 $ , $ \hat{b} = 21.904 $ , $ \hat{\sigma} = 79.099 $ と推定されます。

視覚化のため、プロットもアヒル本の図4.3から拝借してきました(githubへリンク)。このような見た目のデータで、直線は最尤推定によるもの。灰色は信頼性区間。

最尤法に関連したおさらい

傾き $ b $ , 切片 $ a $ に関して、$ n $ をサンプル数とおいたとき、それぞれ、$ \hat{a} \sim \mathcal{N}(a, \sigma^2 \{\frac{1}{n} + \frac{\bar{X}^2}{\sum_{ i = 1 }^{ n } (X_n - \bar{X})^2} \}) $ , $ \hat{b} \sim \mathcal{N}(b, \frac{\sigma^2}{\sum_{ i = 1 }^{ n } (X_n - \bar{X})^2 }) $ , $ \hat{\sigma}^2 \sim \chi_{n-2}^2 \frac{\sigma^2}{n-2} $ ですから、 それぞれの信頼区間は以下の通り。 $$ a \in \left[\hat{a}-t_{\alpha/2,n-2} \hat{\sigma} \sqrt{\frac{1}{n} + \frac{\bar{X}^2}{\sum_{ i = 1 }^{ n } (X_n - \bar{X})^2}}, \hat{a}+ t_{\alpha/2,n-2} \hat{\sigma} \sqrt{\frac{1}{n} + \frac{\bar{X}^2}{\sum_{ i = 1 }^{ n } (X_n - \bar{X})^2}} \right] $$ $$ b \in \left[\hat{b}-t_{\alpha/2,n-2} \frac{\hat{\sigma}}{\sqrt{\sum_{ i = 1 }^{ n } (X_n - \bar{X})^2 }}, \hat{b}+ t_{\alpha/2,n-2} \frac{\hat{\sigma}}{\sqrt{\sum_{ i = 1 }^{ n } (X_n - \bar{X})^2 }} \right] $$ $$ \sigma^2 \in \left[\frac{(n-2)\hat{\sigma}}{\chi^2_{1-\alpha/2}}, \frac{(n-2)\hat{\sigma}}{\chi^2_{\alpha/2}} \right] $$

値を代入して95%信頼区間を計算します。$$ a \in \left[-262.8, 23.5 \right] $$ $$ b \in \left[18.7, 25.1 \right] $$ $$ \sigma^2 \in \left[3572, 13683 \right] $$ $$ \sigma \in \left[59.7, 117.0 \right] $$

参考

証明や理論的背景は、ガウス=マルコフの定理あるいは赤本の第13章を参照お願いいたします。

統計入門
統計学入門 (基礎統計学Ⅰ)
  • 編集: 東京大学教養学部統計学教室
  • 出版社/メーカー: 東京大学出版会
  • 発売日: 1991/7/9


統計値まとめ(Ground Truth)

以上をMCMC結果のGround Truthとして扱いますので、ここで一旦まとめ (信頼区間と確信区間を同じに扱っていますが、単回帰では数値的に同じになるはず)

パラメータ名 点推定 95%信頼区間下限値 95%信頼区間上限値 標準誤差
a(切片) -119.7 -262.8 23.5 68.15
b(傾き) 21.9 18.7 25.1 1.52
sigma(残差偏差) 79.1 59.7 117.0  

環境

シミュレーションで使った環境のご紹介。

  • Windows 10 - 64bit
  • Julia 0.6.1
  • mamba 0.11.1
  • R 3.4.3
  • RTools34
  • RStan Version 2.16.2

対数尤度関数(Likelihood function)

対数尤度関数 $ \mathcal{L} (y|a, b, sigma) $ は、こちら。$$ \mathcal{L} (y|a, b, \sigma)=log(\prod_{k=1}^n \mathcal{N}(y_k | a+b \cdot x_k, \sigma^2)) \\= - \frac{n}{2} log(2 \pi) - n \cdot log(\sigma) - \frac{\sum_{k=1}^n (y_k - a - b \cdot x_k)^2}{2 \sigma^2} $$

Distributions.jlを使って書きます。

using Distributions
function likelihood(a, b, sigma)
    y_pred = a + b*x
    likelihoods = [logpdf(Normal(aa, sigma), bb) for (aa,bb) in zip(y_pred,y)]
    l_sum = sum(likelihoods)
    return l_sum
end

通常MCMCによるフィッティングでは実施しないかもしれませんが、今回は収束値が最尤法で求められるので、点推定の値を中心に、対数尤度の分布をプロットして分布を確認します。

using Plots
pyplot()
# 点推定の値(を整数に丸めた)
a = -120.0
b = 22.0
sigma = 79.0

# 分布をみる範囲
a_list = collect(-262:24)
b_list = collect(18:0.1:25)
sigma_list = collect(59:117)

ab_list = [likelihood(tmp_a,tmp_b,sigma) for tmp_a in a_list, tmp_b in b_list]
ac_list = [likelihood(tmp_a,b,    tmp_sigma) for tmp_a in a_list, tmp_sigma in sigma_list]
cb_list = [likelihood(a, tmp_b,tmp_sigma) for tmp_sigma in sigma_list, tmp_b in b_list]

levels = collect(-160:2.5:-115)

p1 = contour(b_list,a_list,ab_list,levels=levels, xlabel="b", ylabel="a")
p2 = contour(sigma_list,a_list,ac_list, levels=levels, xlabel="sigma", ylabel="a")
p3 = contour(b_list,sigma_list,cb_list, levels=levels, xlabel="b", ylabel="sigma")

plot(p1,p2,p3)

この通り、b(傾き)に対して敏感で、次点でa(切片),最後にsigmaという様子が見られます。後述する通り色々試してみた中ではRandom-Walk Metropolis Hasting法やHMC法では、 この感度が収束に影響を及ぼしているようでした。MCMCにも機械学習に於ける正規化の考え方が必要ということです。


ランダムウォーク=メトロポリス・ヘイスティングス法

アルゴリズムの詳細は触れなくても大丈夫ですよね。おさらい用にリンク貼っておきますね。

Github →Mamba.jl_Practice/Random-walk MH.ipynb at 13b26fe1458a3f0e41b880e25650fcadecbbee5b · Chachay/Mamba.jl_Practice

提案分布

この手法による唯一のチューニング対象(?)はランダムウォークの仕方。酔歩に性格の良い正規分布を使うことを前提にして、分散がチューニングの対象です。 直感的にコーシー・シュワルツの不等式的な発想で各パラメータの事後分布の分散の比率に提案分布が近いとサンプリング効率が良いような気がしています。

function proposal(a, b, sigma)
  return [rand(Normal(mu, sd)) for (mu, sd) in zip([a, b, sigma],[80,1,8])]
end

試しに提案分布のaの分散をいじります。

どうです。aの標準誤差65に近い80が一番良い雰囲気出していませんか?aの分散を1にしたものと60にしたもので、3000サンプル分のランダムウォークの違いを見てみます。

分散=1

分散=60

分散60のほうが心なしか良さそうですよね(点推定値への収束が悪いなぁ)

さらに提案分布を多変量正規分布にすると、より一層良くなりそうな気がしていますが、色々やっておいてなんですが、事前にパラメータの分布がわかっているのも興ざめなので、ここ迄にしておきます。

参考:How to derive variance-covariance matrix of coefficients in linear regression - Cross Validated

メトロポリス・ヘイスティングス法の結果

チューニングしてみましたが(a, b)=(-70, 20.9)など、aが心持ち原点に寄ってくるところが解せないです。初期値を最尤法による点推定の値にしても、aが-70前後に寄ってきてしまうので頭抱えています。 実行のたびに-120を中心に-190~-70でブレるというのならわかるけど、毎回原点側に戻って来てしまうのは、 どういうことなの!?

aが原点に寄る…はっ、桁落ちでは?!

ということで、採択率の計算方法を少し変えました。$$ \alpha = exp(log(p^*) - log(p_t)) $$

を$$ \alpha = \frac{exp(log(p^*))}{exp(log(p_t))} $$ に変えました。

Before

tmp1 = posterior(proposal_draw[1],proposal_draw[2],proposal_draw[3])
tmp2 = posterior(chain[i][1], chain[i][2], chain[i][3])
alpha = min(1,exp(tmp1-tmp2))

After

tmp1 = posterior(proposal_draw[1],proposal_draw[2],proposal_draw[3])
tmp2 = posterior(chain[i][1], chain[i][2], chain[i][3])
alpha = min(1,exp(tmp1)/exp(tmp2))

何度か計算させてみても、大体、最尤法の点推定を中心にばらつきます。難点は対数尤度(負の値)が小さすぎるとゼロ割相当になってしまうことでしょうか。

数字で見て見ると $ (a, b, \sigma) = (-122.4, 22.0, 82.2) $ となり、良い!良いです!

mamba.jlでaが小さめに出る問題、桁落ちの可能性もありますね。実際mamba.jlのRandom-Walk MH法では、採択率の計算がこうなっています。きっと同じ症状が出ると思います。

他にもみていくとmamba.jlのHMCにも同じような箇所があり、少し心配になります。NUTSの実装ではHMCを使っていないように見えますので、杞憂かなぁ。

しかし、このような実装がNUTSにも…

不審ですが、これを確認するためHMCに行ってみましょう。

ハミルトニアンモンテカルロ法(HMC)

アルゴリズムについては、ここで、わざわざ書くほどでもないほど、色々な方が記事書いてますし、Stanのマニュアルも充実しています。

短く言うと $ P $ を運動量に見立てて、対数尤度関数をポテンシャル場に使いながら$$ H([a, b, \sigma], [P_a, P_b, P_{\sigma}]) = - likelihood(a, b, \sigma) + \frac{P_{a}^2+P_{b}^2+P_{\sigma}^2}{2} $$ で定義される「ハミルトニアン」を利用して無駄な酔歩を抑えようという感じの発想のアルゴリズムですね。 焼きなまし法みたいに、Iterationのたびにランダムな運動量(≒初速)を与えた玉を少し転がしてやってからサンプリングを繰り返し、 最終的に谷底の中心で跳ね回るようにしていく動作をします。

その効果がこちらのような素早い谷底への到達!!

ポテンシャルエネルギー $ U(a, b, \sigma) = -likelihood(a, b, \sigma) $ 、 運動エネルギー $ K(P_a, P_b, P_{\sigma}) = \frac{P_{a}^2+P_{b}^2+P_{\sigma}^2}{2} $と定義すると、ハミルトニアン $ H = U + K $ になりますね。 これを手を離した振り子の要領で、系のエネルギーを保存しながら、動いてもらおうと思うと、 ハミルトン力学でいうところの正準方程式を数値解法で解いていきます。 これには、シンプレクティックな数値積分法リープ・フロッグ法を使います。

使わないと面倒なことになりそう。

ということでリープフロッグ法で対数尤度関数の偏微分を使いますので、計算します。$$ \mathcal{L} (y|a, b, \sigma)= - \frac{n}{2} log(2 \pi) - n \cdot log(\sigma) - \frac{\sum_{k=1}^n (y_k - a - b \cdot x_k)^2}{2 \sigma^2} $$ $$ \frac{\partial \mathcal{L} (y|a, b, \sigma)}{\partial a}= \frac{\sum_{k=1}^n (y_k - a - b \cdot x_k)}{\sigma^2} $$ $$ \frac{\partial \mathcal{L} (y|a, b, \sigma)}{\partial b}= \frac{\sum_{k=1}^n x_k (y_k - a - b \cdot x_k)}{\sigma^2} $$ $$ \frac{\partial \mathcal{L} (y|a, b, \sigma)}{\partial \sigma}= -\frac{n}{\sigma} + \frac{\sum_{k=1}^n (y_k - a - b \cdot x_k)^2}{\sigma^3} $$

function dlikelihood(a, b, sigma)
  y_pred = a + b*x

  grad_a    = sum(y - y_pred)/sigma^2
  grad_b    = dot(x, y - y_pred)/sigma^2
  grad_sigma= -1.0/sigma * length(x) + sum(abs2,y - y_pred)/sigma^3

  return [grad_a, grad_b, grad_sigma]
end

で、Leapfrogの実装は

function Leapfrog(theta, r, epsilon)
    r += 0.5 * epsilon * dlikelihood(theta[1], theta[2], theta[3])
    theta +=   epsilon * r
    r += 0.5 * epsilon * dlikelihood(theta[1], theta[2], theta[3])
    return theta, r
end

ポテンシャルエネルギーをlikelihoodの-1倍で定義したので、マイナスがキャンセルして"r-="ではなく"r+="になっています。あしからず。

Github →Mamba.jl_Practice/HMC-MassMatrix.ipynb

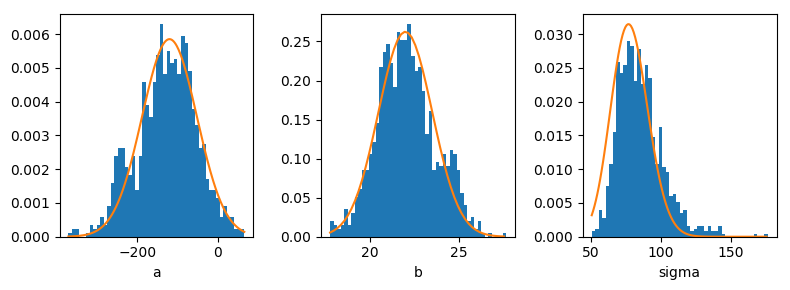
ステップ数 $ L = 100 $, サンプリング周期 $ \epsilon = 0.2 $ として点推定値付近を50,000 Iterationsほどウロウロさせると、良さそうな雰囲気。

最尤値(オレンジ実線)とサンプリングの比較

$ (mean(a), mean(b), mean(\sigma)) = (-118.0, 21.9, 85.4) $ で、桁落ちの影響もなく良さそうですね。mamba.jlの問題はなんだか、特定できず終いです。

ここまでの話は、この本でカバーされているようなので…ほしいけどゴクリ…。

Bayesian Data Analysis
Bayesian Data Analysis, Third Edition
  • 作者: Andrew Gelman et al.
  • 出版社/メーカー: Chapman and Hall/CRC
  • 発売日: 2013/11/5